Unicode คืออะไร? อักษรพิเศษกับฟอนต์ต่างกันอย่างไร
| อักขระ | รหัส | UTF-8 (ไบต์) | UTF-16 (หน่วย) | ประเภท |
|---|
Unicode คือมาตรฐานที่ให้ “รหัสประจำตัว” กับตัวอักษรทุกตัวในโลก ตั้งแต่ A, ก, ♡ ไปจนถึงอีโมจิ 😀 เมื่อทุกเครื่องใช้รหัสชุดเดียวกัน ข้อความที่พิมพ์บน iPhone จึงไปแสดงบน Android หรือคอมพิวเตอร์ได้ตรงกัน วางข้อความหรืออักษรพิเศษลงในช่องด้านบนเพื่อดูรหัส U+ ของแต่ละตัว และดูว่าข้อความนั้นยาวกี่ไบต์ (อัปเดตล่าสุด: ตุลาคม 2569)
Unicode คืออะไร (อธิบายแบบสั้นที่สุด)
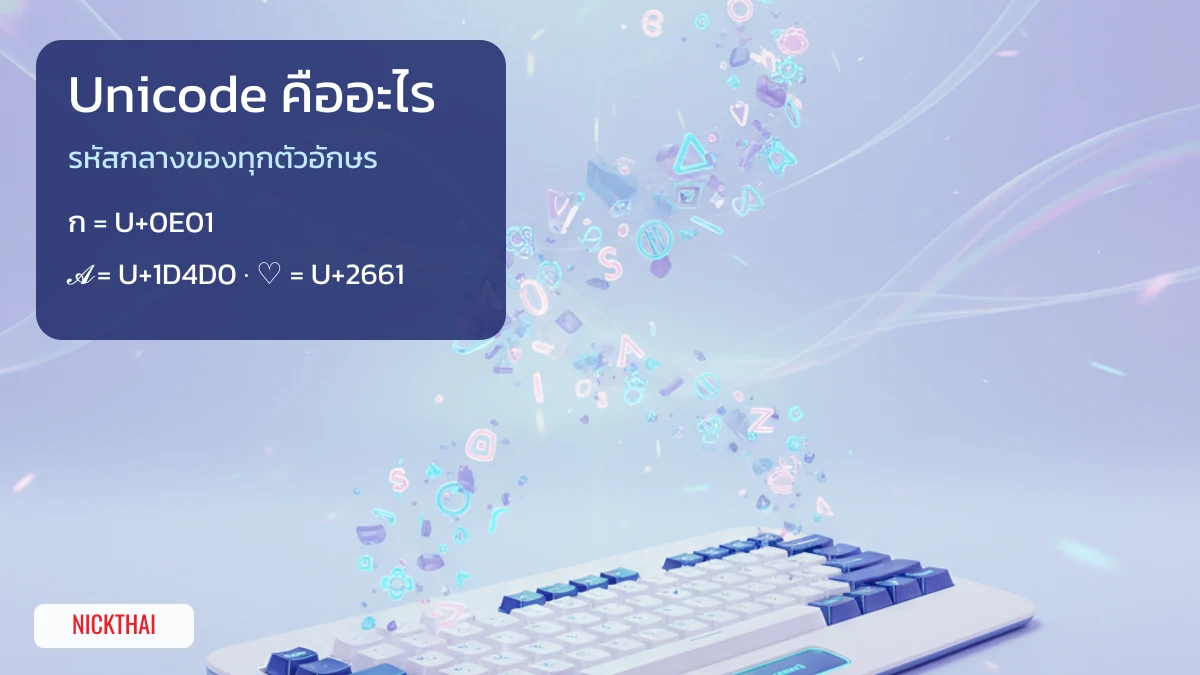
คอมพิวเตอร์เก็บได้แต่ตัวเลข ตัวอักษรทุกตัวจึงต้องมีเลขประจำตัวที่เรียกว่า code point เขียนในรูป U+ ตามด้วยเลขฐานสิบหก เช่น ก คือ U+0E01 และ A คือ U+0041 Unicode เป็นผู้กำหนดว่าเลขไหนคือตัวอะไร โดยพัฒนาคู่กับมาตรฐานสากล ISO/IEC 10646 ให้ตรงกัน และเป็นชุดอักขระที่ภาษาและรูปแบบข้อมูลอย่าง JavaScript, Java และ XML ใช้เป็นพื้นฐาน
พื้นที่รหัสทั้งหมดมี 1,114,112 ช่อง (U+0000 ถึง U+10FFFF) แบ่งเป็น 17 ระนาบ (plane) ระนาบละ 65,536 ช่อง ระนาบแรกเรียกว่า BMP เก็บตัวอักษรที่ใช้บ่อยเกือบทุกภาษา รวมถึงภาษาไทย ส่วนอีโมจิและตัวหนาแบบคณิตศาสตร์ส่วนใหญ่อยู่ในระนาบที่ 1 ซึ่งเป็นเหตุผลว่าทำไมมันกินพื้นที่มากกว่า (ดูหัวข้อ UTF-8) ใน Unicode 17.0 ที่ออกเมื่อกันยายน 2568 มีตัวอักษรที่กำหนดแล้ว 159,801 ตัว ช่องที่เหลือยังว่างไว้สำหรับอนาคต
| ตัวอักษร | Code point | อยู่ในบล็อก |
|---|---|---|
| A | U+0041 | Basic Latin (ชุดเดียวกับ ASCII) |
| ก | U+0E01 | Thai |
| ♡ | U+2661 | Miscellaneous Symbols |
| 亗 | U+4E97 | CJK Unified Ideographs |
| 𝓐 | U+1D4D0 | Mathematical Alphanumeric Symbols |
| 😀 | U+1F600 | Emoticons |
อักษรพิเศษ คืออะไร และ สัญลักษณ์ คืออะไร
อักษรพิเศษ คือคำเรียกแบบบ้าน ๆ ของตัวอักษร Unicode ที่ไม่มีบนแป้นพิมพ์ปกติ แต่คัดลอกไปวางได้ ส่วน สัญลักษณ์ คืออักขระที่ไม่ใช่ตัวอักษรของภาษาใด เช่น ♡ ★ ✿ Unicode แยกประเภทไว้เป็นหมวด (General Category) ทำให้เราอธิบายได้ว่าอักษรพิเศษแต่ละแบบที่เห็นบน NickThai ตัวอักษรพิเศษ จริง ๆ แล้วคืออะไร
| แบบที่เห็นบ่อย | ตัวอย่าง | จริง ๆ คืออะไรใน Unicode |
|---|---|---|
| สัญลักษณ์ตกแต่ง | ♡ ✦ ☁︎ ✿ | หมวด So (Symbol, other) จากบล็อก Dingbats และ Miscellaneous Symbols |
| ตัวอังกฤษแบบหนา เอียง ลายมือ | 𝐀 𝘼 𝓐 𝔄 | ตัวอักษรคนละรหัสกับ A ปกติ อยู่ในบล็อกสำหรับสัญลักษณ์คณิตศาสตร์ |
| ตัวในวงกลม | ⓐ ① ㉑ | บล็อก Enclosed Alphanumerics และ Enclosed CJK |
| ตัวคล้ายภาษาอื่น | 亗 ᴀ ツ | อักษรจริงของภาษาจีน สัทอักษร และคาตากานะ ที่ถูกหยิบมาใช้เพราะรูปทรงสวย |
| ช่องว่างล่องหน | (มองไม่เห็น) | หมวด Zs และ Cf หรือบางตัวเป็นตัวอักษรที่ไม่มีรูป เช่น U+3164 |
| คาโอโมจิ | (。•̀ᴗ-)✧ | ไม่ใช่อักขระเดียว แต่เป็นหลายตัวจากหลายบล็อกเรียงกัน |
ลองคัดลอกตัวอย่างด้านล่างไปวางในช่องตรวจรหัสด้านบนสุด จะเห็นว่าแต่ละชุดประกอบด้วยรหัสอะไรบ้าง
ช่องว่างล่องหนเป็นกรณีที่คนสับสนมากที่สุด เพราะบางตัวเป็น “ช่องว่าง” ตามหมวด แต่บางตัวถูกนับเป็นตัวอักษรที่ไม่มีรูป เกมและแอปจึงรับไม่เหมือนกัน รายละเอียดและตัวที่ใช้ได้อยู่ในหน้า ตัวอักษรว่าง คัดลอกได้
ฟอนต์ ≠ อักษรพิเศษ: ต่างกันตรงไหน
หลักจำง่าย ๆ คือ Unicode กำหนดว่า “เป็นตัวอะไร” ส่วนฟอนต์กำหนดว่า “หน้าตาเป็นแบบไหน” ถ้าเปลี่ยนฟอนต์ใน Word ตัว A ยังเป็นรหัส U+0041 เหมือนเดิม พอคัดลอกไปวางในไอจี แอปจะวาดด้วยฟอนต์ของแอปเอง ความสวยจึงหายไป แต่ 𝓐 เป็นรหัส U+1D4D0 ซึ่งเป็นตัวอักษรคนละตัวตั้งแต่ต้น หน้าตาลายมือจึงติดไปทุกแอป
| ฟอนต์ (ไฟล์ .ttf / .otf) | อักษรพิเศษ Unicode | |
|---|---|---|
| เปลี่ยนอะไร | รูปร่างของรหัสเดิม | ตัวรหัสเอง |
| คัดลอกไปแอปอื่น | หน้าตากลับเป็นแบบปกติ | หน้าตาติดไปด้วย |
| ต้องติดตั้งไหม | ต้องติดตั้งในเครื่อง | ไม่ต้อง |
| ใช้กับภาษาไทย | มีฟอนต์ไทยสวย ๆ ให้เลือกมาก | ไม่มีชุดตัวหนาหรือลายมือสำหรับอักษรไทย |
| ค้นหาและโปรแกรมอ่านหน้าจอ | อ่านได้ปกติ | อาจอ่านไม่ออกหรืออ่านเป็นชื่อสัญลักษณ์ |
ถ้าต้องการแปลงข้อความเป็นแบบลายมือ ตัวหนา หรือวงกลมทันที ใช้ เครื่องมือแปลงฟอนต์สวยๆ ฟอนต์น่ารัก ในหน้านั้นมีตารางบอกด้วยว่าแต่ละสไตล์มาจากบล็อก Unicode ไหน และสไตล์ไหนมีตัวเลขครบ
ภาษาไทยใน Unicode: บล็อก U+0E00–U+0E7F
อักษรไทยทั้งหมดอยู่ในบล็อก Thai ช่วง U+0E00 ถึง U+0E7F ซึ่งมีอักขระที่ใช้งานจริง 87 ตัว ได้แก่ พยัญชนะ สระ วรรณยุกต์ เลขไทย และเครื่องหมายอย่าง ๆ ฯ ฿ จุดที่น่าสนใจคือ Unicode วางตำแหน่งตามมาตรฐานไทยเดิม TIS-620 (มอก. 620) ทุกตัว แค่บวกค่าคงที่ 0xD60 เข้าไป
| ตัวอักษร | รหัส TIS-620 | + 0xD60 = | Unicode |
|---|---|---|---|
| ก | 0xA1 | 0xA1 + 0xD60 | U+0E01 |
| ข | 0xA2 | 0xA2 + 0xD60 | U+0E02 |
| ฿ | 0xDF | 0xDF + 0xD60 | U+0E3F |
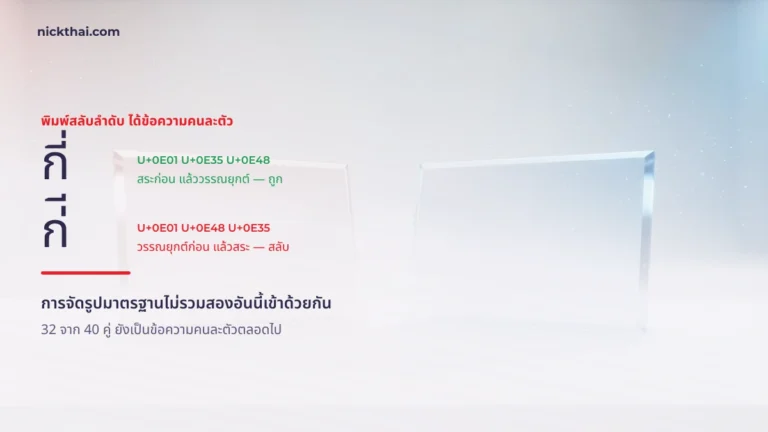
สระบนล่างและวรรณยุกต์เป็นอักขระแยกที่ซ้อนบนพยัญชนะ คำว่า “กี่” จึงเป็น 3 รหัส (U+0E01 U+0E35 U+0E48) แม้ตาเห็นเป็นช่องเดียว ถ้าพิมพ์สลับลำดับเป็นวรรณยุกต์ก่อนสระ บนจอจะดูเหมือนกันแต่เป็นคนละข้อความ ช่องค้นหาในเกมจึงหาชื่อไม่เจอ ปัญหานี้อธิบายพร้อมวิธีแก้ไว้ในบทความ ลำดับสระวรรณยุกต์ที่ทำให้ชื่อไทยหาไม่เจอ
UTF-8 คืออะไร และ Unicode ขนาดกี่ byte
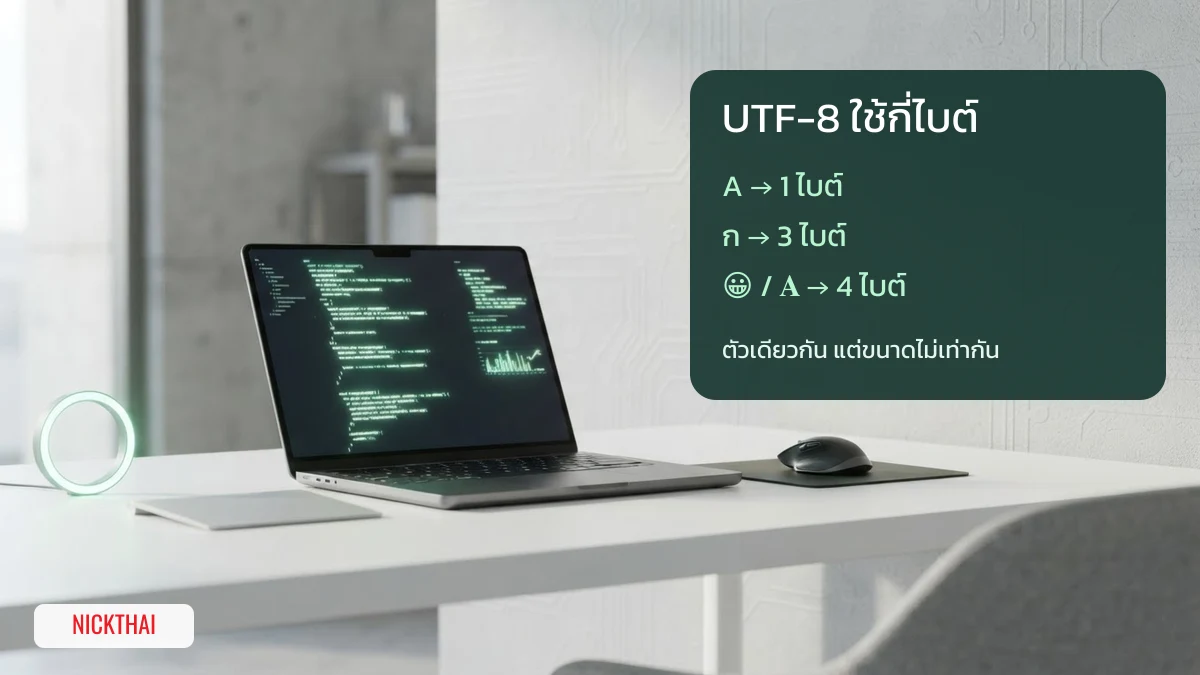
Unicode บอกแค่เลขรหัส แต่ไม่ได้บอกว่าจะเก็บเลขนั้นลงไฟล์อย่างไร วิธีเก็บเรียกว่า การเข้ารหัส (encoding) ที่ใช้มากที่สุดคือ UTF-8 ซึ่งใช้ 1 ถึง 4 ไบต์ต่อตัวตามขนาดของเลขรหัส อีกแบบที่พบบ่อยคือ UTF-16 ใช้ 1 หรือ 2 หน่วย หน่วยละ 16 บิต คำถามว่า “Unicode ขนาดกี่ byte” จึงไม่มีคำตอบเดียว ขึ้นอยู่กับตัวอักษรและการเข้ารหัส
| ตัว | คืออะไร | รหัส | UTF-8 (ไบต์) | UTF-16 (หน่วย) |
|---|---|---|---|---|
| A | ตัวอังกฤษ | U+0041 | 1 | 1 |
| ก | พยัญชนะไทย | U+0E01 | 3 | 1 |
| ◌่ | ไม้เอก | U+0E48 | 3 | 1 |
| ♡ | หัวใจขาว | U+2661 | 3 | 1 |
| 亗 | อักษรจีนยอดฮิตในชื่อเกม | U+4E97 | 3 | 1 |
| 𝓐 | ตัวลายมือหนา | U+1D4D0 | 4 | 2 |
| 😀 | อีโมจิ | U+1F600 | 4 | 2 |
| 👍🏽 | อีโมจิ + โทนผิว | U+1F44D U+1F3FD | 8 | 4 |
| 🇹🇭 | ธงไทย | U+1F1F9 U+1F1ED | 8 | 4 |
| 👨👩👧 | อีโมจิครอบครัว | 5 รหัส | 18 | 8 |
จากตารางจะเห็นว่าอีโมจิบางตัวที่ดูเป็นรูปเดียวจริง ๆ ประกอบจากหลายรหัส ธงไทยคือตัวอักษรภูมิภาค T กับ H ต่อกัน ส่วนอีโมจิครอบครัวคือคน 3 คนเชื่อมด้วยตัวเชื่อมล่องหน U+200D รวม 5 รหัส 18 ไบต์
ทำไมชื่อในเกมนับตัวอักษรไม่ตรงกับที่ตาเห็น
ช่องชื่อในเกมและแอปแต่ละที่นับความยาวคนละแบบ บางที่นับเป็นไบต์ บางที่นับเป็นหน่วย UTF-16 หรือนับรหัส ชื่อ “𝓐𝓵𝓮𝔁” ที่ตาเห็น 4 ตัว จึงอาจถูกนับเป็น 8 หน่วยหรือ 16 ไบต์ และชื่อไทยที่มีสระบนล่างก็ยาวกว่าที่เห็นเสมอ ก่อนตั้งชื่อยาว ๆ ให้วางในช่องตรวจด้านบนดูตัวเลขทั้งสามแบบก่อน
ตัวอย่างการนับที่เจอบ่อยคือชื่อในเกม PUBG MOBILE ที่ใส่อักษรพิเศษได้ไม่กี่ตัวก็เต็ม ดูตัวอย่างชื่อที่พอดีช่องได้ใน ชื่อ PUBG อักษรพิเศษ ส่วนเกมที่ไม่รับอักษรพิเศษบางหมวดเลย สรุปไว้ในหน้า อักษรพิเศษใช้ในเกมหรือแอปได้จริงไหม
ASCII คืออะไร และทำไมภาษาไทยเพี้ยนเป็น “เธ”
ASCII คือมาตรฐานรหัสตัวอักษรรุ่นเก่าที่มีแค่ 128 ตัว (0–127) ครอบคลุมตัวอังกฤษ ตัวเลข เครื่องหมายวรรคตอน และรหัสควบคุม ไม่มีภาษาไทย ประเทศต่าง ๆ จึงทำชุดของตัวเองขึ้นมา สำหรับไทยคือ TIS-620 และ Windows-874 Unicode รวมทุกชุดไว้ในที่เดียว และคง 128 ตัวแรกให้ตรงกับ ASCII ทุกตัว ไฟล์ภาษาอังกฤษล้วนแบบ ASCII จึงเป็น UTF-8 ที่ถูกต้องไปในตัว
อาการภาษาไทยกลายเป็น เธ เธฒเธฉเธฒเน„เธ—เธข เกิดจากข้อความ UTF-8 ถูกเปิดด้วยการเข้ารหัสไทยแบบเก่า ตัวไทยหนึ่งตัวใช้ 3 ไบต์ โดยไบต์แรกตรงกับ “เ” และไบต์ที่สองมักตรงกับ “ธ” ในตาราง Windows-874 จึงเห็น เธ ซ้ำ ๆ วิธีแก้คือเปิดไฟล์ใหม่โดยเลือกการเข้ารหัสเป็น UTF-8 ข้อความไม่ได้เสีย
ทำไมอักษรพิเศษขึ้นเป็น □ หรือ �
สองอาการนี้ดูคล้ายกันแต่สาเหตุต่างกัน
- □ ช่องสี่เหลี่ยมว่าง (คนทำฟอนต์เรียกว่า tofu): รหัสถูกต้อง แต่เครื่องที่เปิดดูไม่มีฟอนต์ที่วาดตัวนั้น มักเจอกับอีโมจิรุ่นใหม่บนมือถือรุ่นเก่า หรืออักษรจากบล็อกที่ใช้น้อย ถ้าส่งต่อไปเครื่องที่รองรับ จะแสดงได้ปกติ
- � เครื่องหมายคำถามในรูปข้าวหลามตัด (U+FFFD): ข้อมูลเสียจริงหรือถูกอ่านด้วยการเข้ารหัสผิด เช่น ข้อความถูกตัดกลางไบต์ของตัวอักษร 4 ไบต์ อันนี้ส่งต่อไปเครื่องไหนก็ไม่กลับมา ต้องคัดลอกจากต้นทางใหม่
ถ้าอยากให้ชื่อหรือไบโอแสดงได้ทุกเครื่อง เลือกอักษรพิเศษจากบล็อกที่มีมานาน เช่น ♡ ★ และตัวหนาคณิตศาสตร์ ซึ่งมือถือส่วนใหญ่มีฟอนต์รองรับอยู่แล้ว
ตัวอย่างอักษรพิเศษแยกตามบล็อก Unicode
อักษรพิเศษที่เห็นในชื่อเกมและไบโอไม่ได้มาจากที่เดียว แต่กระจายอยู่หลายบล็อก ตัวอย่างด้านล่างจัดกลุ่มตามบล็อกจริงพร้อมช่วงรหัส แตะเพื่อคัดลอก แล้วนำไปวางใน ช่องตรวจรหัส ด้านบนเพื่อดูว่าแต่ละตัวใช้กี่ไบต์ ตัวที่อยู่ในบล็อกเก่าอย่าง Miscellaneous Symbols มีโอกาสขึ้นเป็น □ น้อยกว่าตัวในบล็อกใหม่
คำเดียว 16 แบบ: ตัวอักษรคนละบล็อก
คำว่า Unicode ด้านล่างเป็นคำเดียวกันที่แปลงเป็นอักษรคนละชุด ป้ายใต้แต่ละแบบบอกรหัสของตัวแรก ส่วนใหญ่อยู่ในบล็อก Mathematical Alphanumeric Symbols (U+1D400–U+1D7FF) แบบวงกลม สี่เหลี่ยม และเต็มความกว้างมาจากบล็อกอื่น ส่วนแบบขีดฆ่าและขีดเส้นใต้ไม่ใช่ตัวใหม่ แต่เป็นตัวปกติที่ต่อท้ายด้วยเครื่องหมายผสม U+0336 หรือ U+0332 ทุกตัว ความยาวจึงเพิ่มเป็นสองเท่า
Miscellaneous Symbols (U+2600–U+26FF)
บล็อกสัญลักษณ์เบ็ดเตล็ด มีทั้งดวงอาทิตย์ ร่ม ไพ่ และหัวใจแบบเส้น เป็นบล็อกเก่าที่มือถือแทบทุกรุ่นแสดงได้
Dingbats (U+2700–U+27BF)
มาจากชุดสัญลักษณ์ตกแต่งของเครื่องพิมพ์ยุคก่อน จึงมีดาว ดอกไม้ เครื่องหมายถูก และกรรไกร
Geometric Shapes (U+25A0–U+25FF)
รูปทรงเรขาคณิต วงกลมครึ่งซีกกับเส้นโค้ง ◡ ◠ มักถูกหยิบไปทำปากและตาของคาโอโมจิ
Letterlike Symbols (U+2100–U+214F)
สัญลักษณ์ที่หน้าตาเหมือนตัวอักษร เช่น ™ และ ℃ ตัวลายมือบางตัวของสไตล์ Script ก็ยืมมาจากบล็อกนี้
Arrows (U+2190–U+21FF)
ลูกศรทุกทิศทาง ใช้ชี้ลิงก์ในไบโอหรือคั่นข้อความ
อีโมจิ: 3 บล็อกหลัก และอีโมจิที่ต่อจากหลายรหัส
อีโมจิส่วนใหญ่อยู่ในระนาบที่ 1 ทุกตัวจึงใช้ 4 ไบต์ใน UTF-8 แถวแรกมาจาก Emoticons (U+1F600–U+1F64F) แถวที่สองจาก Miscellaneous Symbols and Pictographs (U+1F300–U+1F5FF) และแถวที่สามจาก Supplemental Symbols and Pictographs (U+1F900–U+1F9FF) ซึ่งใหม่กว่า มือถือรุ่นเก่ามากอาจแสดงไม่ได้
แถวสุดท้ายเป็นอีโมจิที่ดูเป็นรูปเดียวแต่ประกอบจากหลายรหัส ป้ายบอกจำนวนรหัสจริง ถ้าเครื่องไม่รองรับการต่อกัน จะเห็นแยกเป็นหลายรูปเรียงกัน
คาโอโมจิ: ตัวอักษรจากหลายบล็อกเรียงกัน
คาโอโมจิไม่มีบล็อกของตัวเอง ใบหน้าหนึ่งหน้าอาจหยิบตัวอักษรจาก 4–5 บล็อกมาต่อกัน ป้ายใต้บางแบบบอกที่มาของชิ้นส่วน
คอมโบหลายบล็อกในบรรทัดเดียว
ชุดตกแต่งสายดาว ดวงจันทร์ ก้อนเมฆ และดอกไม้ ผสมสัญลักษณ์จากหลายบล็อกไว้ในบรรทัดเดียว เหมาะเป็นตัวอย่างสำหรับลองนับความยาวในช่องตรวจรหัส
Unicode มาจากไหน
Unicode ดูแลโดยองค์กรไม่แสวงกำไรชื่อ Unicode Consortium และออกเวอร์ชันใหม่ปีละครั้ง ช่วงหลังมักออกในเดือนกันยายน ตั้งแต่เวอร์ชัน 2.0 มีนโยบายไม่ลบหรือย้ายรหัสที่กำหนดไปแล้ว ข้อความที่เขียนวันนี้จึงยังอ่านได้ในอนาคต
| เวอร์ชัน | ปี | จุดเปลี่ยนที่เกี่ยวกับผู้ใช้ทั่วไป |
|---|---|---|
| 1.0 | 2534 (1991) | เวอร์ชันแรกของมาตรฐาน |
| 2.1 | 2541 (1998) | เพิ่มเครื่องหมายยูโร € |
| 6.0 | 2553 (2010) | เพิ่มอีโมจิชุดใหญ่ ที่มาจากโทรศัพท์มือถือญี่ปุ่น |
| 17.0 | 2568 (2025) | มีตัวอักษรรวม 159,801 ตัว |
คำถามที่พบบ่อย
Unicode ขนาดกี่ byte?
ขึ้นอยู่กับการเข้ารหัส ใน UTF-8 ตัวอังกฤษใช้ 1 ไบต์ ตัวไทยใช้ 3 ไบต์ อีโมจิและตัวหนาแบบคณิตศาสตร์ใช้ 4 ไบต์ ส่วน UTF-16 ใช้ 2 หรือ 4 ไบต์ต่อรหัส
Unicode กับ UTF-8 ต่างกันอย่างไร?
Unicode คือตารางที่กำหนดว่าเลขไหนคือตัวอักษรอะไร ส่วน UTF-8 คือวิธีเก็บเลขเหล่านั้นเป็นไบต์ลงไฟล์หรือส่งผ่านเครือข่าย
ASCII หมายถึงอะไร?
ASCII คือชุดรหัสตัวอักษร 128 ตัวสำหรับภาษาอังกฤษ ตัวเลข และเครื่องหมาย ซึ่ง Unicode คงไว้เป็น 128 รหัสแรกเหมือนเดิม
ตัวอักษรพิเศษมีอะไรบ้าง?
แบ่งคร่าว ๆ ได้เป็นสัญลักษณ์ตกแต่ง ตัวอังกฤษแบบหนาหรือลายมือ ตัวในวงกลม อักษรต่างภาษาที่รูปทรงสวย ช่องว่างล่องหน และคาโอโมจิที่เกิดจากหลายตัวเรียงกัน
ทำตัวอักษรพิเศษเองได้ไหม?
สร้างรหัสใหม่เองไม่ได้ เพราะรหัสทั้งหมดกำหนดโดย Unicode แต่แปลงข้อความให้ใช้ตัวอักษรชุดอื่นที่มีอยู่แล้วได้ด้วยเครื่องมือแปลงฟอนต์ แล้วคัดลอกไปใช้

เราคัดและทดสอบฟอนต์ ตัวเขียน และตัวอักษรพิเศษให้แสดงผลได้จริงทุกตัวก่อนนำขึ้น อ้างอิงมาตรฐาน Unicode สาธารณะ และอัปเดตตามเทศกาลอย่างสม่ำเสมอ